Fragen
Am Anfang steht eine Frage, die ein Produkt noch nicht beantworten kann.
Archymedes Lab
Das Labor untersucht die Fragen hinter unseren Produkten: wann eine KI handeln sollte, ob ihr Wissen in der Wirklichkeit standhält und wie sie günstig genug wird, um überall zu laufen. Wir veröffentlichen die Methode, den Code und die Grenzen.
Methode
Am Anfang steht eine Frage, die ein Produkt noch nicht beantworten kann.
Gegen die Wirklichkeit testen, nicht danach, wie plausibel etwas wirkt.
Was durchfällt, fliegt raus – so bequem es auch wäre.
Paper, Code, Daten und die benannten Grenzen freigeben.
Programme
Wann sollte eine KI etwas tun, das noch niemand ausprobiert hat?
Generative Modelle sind gut darin, Optionen vorzuschlagen, und schlecht darin, zwischen ihnen zu wählen. Diese Forschungslinie hält beides auseinander: Modelle urteilen, kalibrierte Mathematik entscheidet, und eine unsichere Option wird gegen eine Rückfalloption geprüft, statt per Veto gestoppt zu werden.
Ergebnisse
Stimmt es vor Ort?
Reale Orte aus freien öffentlichen Daten als geprüfte, schlanke 3D-Szenen nachbauen. Jede Schicht wird an der besten verfügbaren Messung ausgerichtet und ihr Fehler ausgewiesen; eine Quelle, die an der Wirklichkeit scheitert, wird verworfen – so bequem sie auch wäre.
Ergebnisse
Läuft es auf gewöhnlicher Hardware?
Leistungsfähige Modelle so günstig machen, dass sie auch dort laufen, wo Verbindungen langsam sind oder ganz fehlen: Kompression und Quantisierung für kleine Sprachmodelle sowie Werkzeuge, die GPU-Code optimieren, ohne die Korrektheit preiszugeben.
Ergebnisse
Publikationen
Wann sollte eine KI eine Idee umsetzen, die noch niemand ausprobiert hat? Sie gegen eine Rückfalloption prüfen, statt sie zu verwerfen – und bepreisen, was die Prüfung übersehen kann.
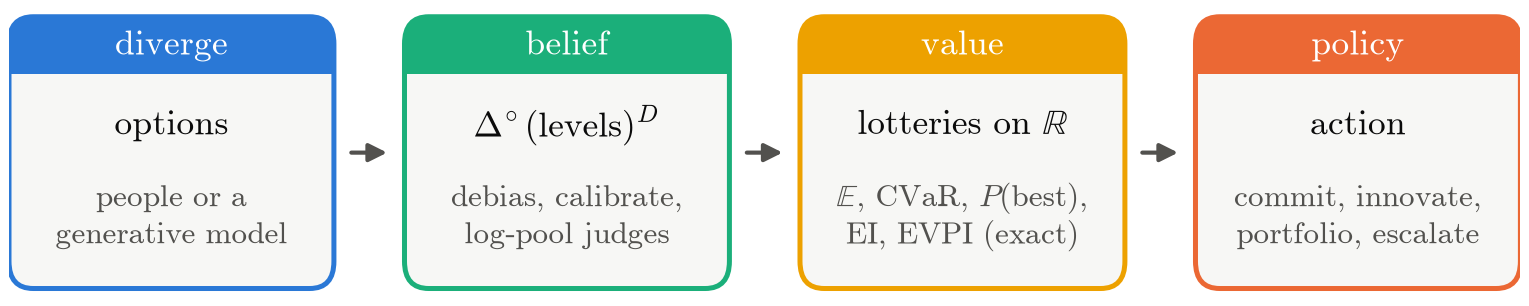
Bei einer einzelnen Entscheidung hängt der Wert einer Prüfung von der Einschätzung des Schadens nur über deren Mittelwert ab. Unwissenheit und ein bekannter Münzwurf rechtfertigen dieselbe Handlung; der Unterschied zählt erst beim Lernen über viele Entscheidungen hinweg.
Auf zurückgehaltenen synthetischen Problemen halbiert das Prüfen unsicherer Optionen das Bedauern gegenüber ihrem Verwerfen (0,045 gegenüber 0,091) bei etwa 1 % unentdecktem Schaden – verglichen mit 17–23 %, wenn man ungeprüft auf sie setzt.
Über 237 Urteile von TypeSafe Jev mit bekannter Grundwahrheit trennt Jev ausdrücklichen Schaden nahezu perfekt von ausdrücklicher Sicherheit (AUROC 0,9998), und cdm weist unter den verglichenen Strategien das geringste Bedauern und den geringsten Schaden auf.
Der Gewinn stammt aus dem Prüfen, nicht aus der CVaR-Zuverlässigkeitsschwelle; der Jev-Benchmark ist klein und schablonenhaft; nichts davon zeigt bislang bessere Entscheidungen bei realen Ergebnissen.
Offen als Standard
Zu jedem Ergebnis, das das Labor veröffentlicht, gehört alles, was man zu seiner Überprüfung braucht. Ist ein Benchmark klein oder ein Datensatz grob, steht das im Paper.